在游戏 PC 上运行 125B 大模型
Strata 项目利用混合专家模型、显存缓存和推测解码,让 12GB 显存的游戏 PC 也能运行 1250 亿参数大模型。
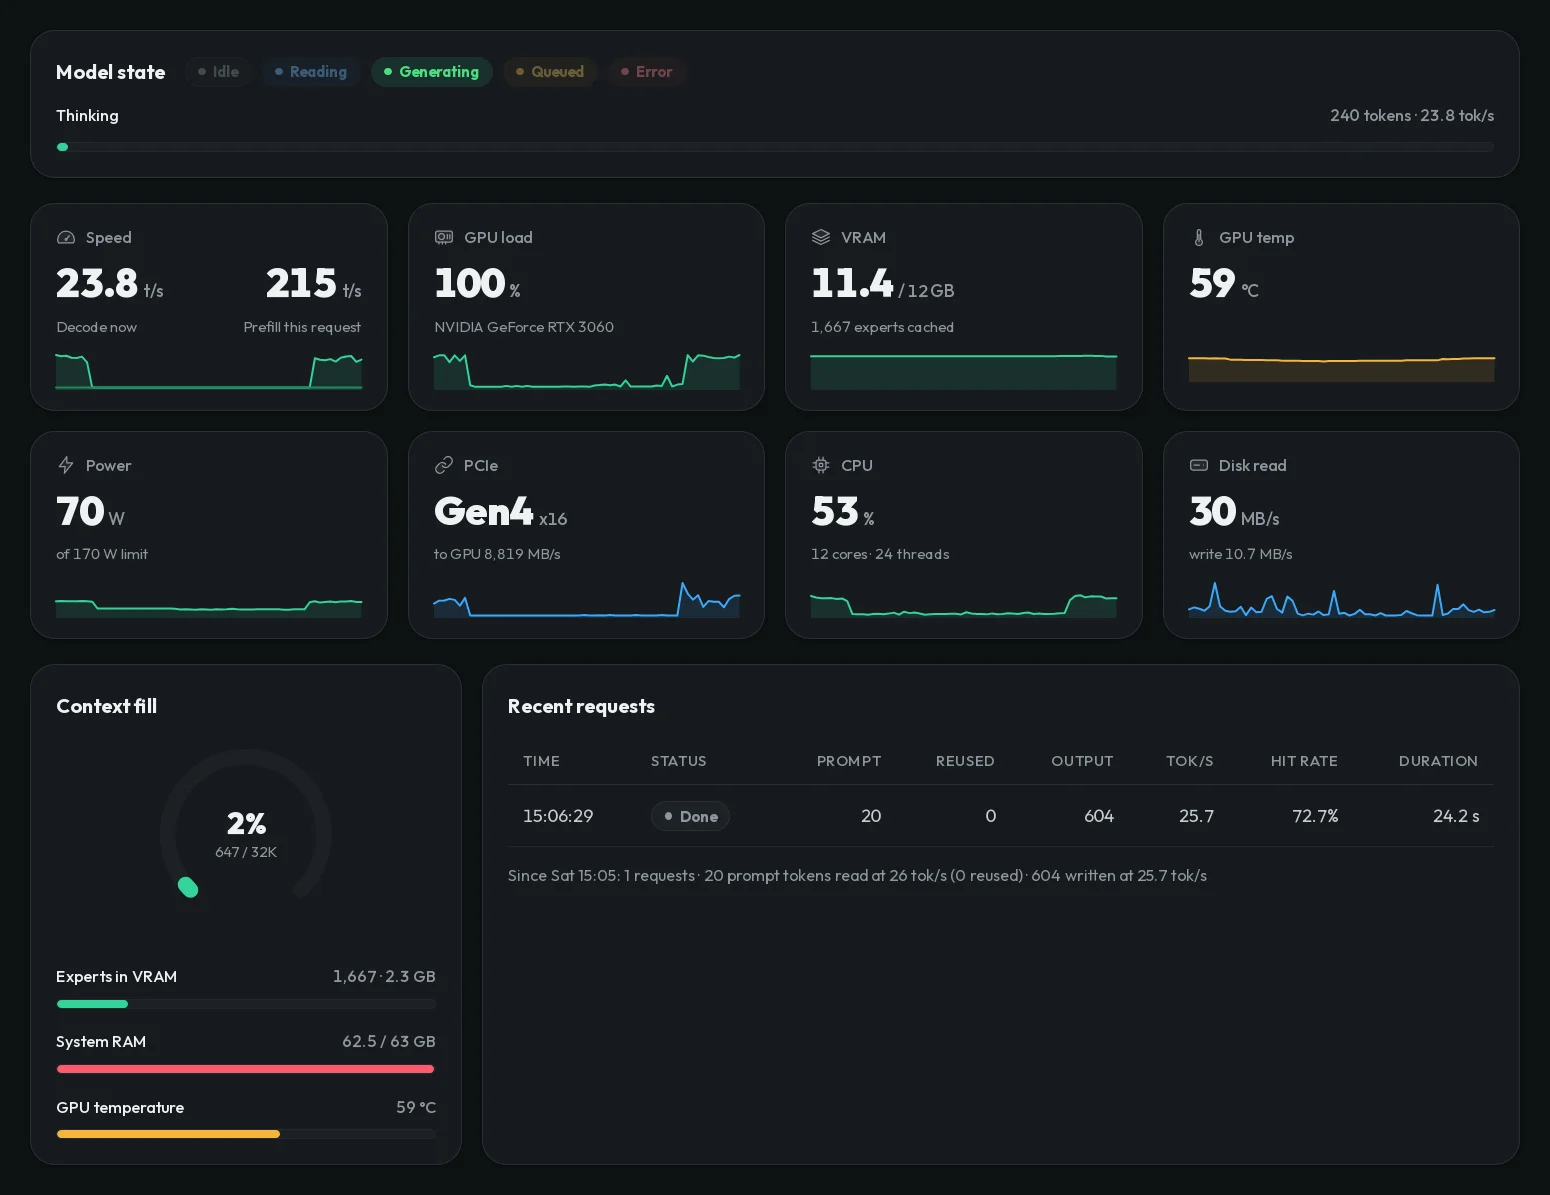
想在本地折腾大语言模型,通常只有两条路:把请求发到别人的服务器,或者搭一套规模不小的 GPU 与 CPU 平台。最近出现的一批项目,则试图把更大的模型塞进普通游戏 PC。
Strata 就是其中之一。这个由 Niko1221 开发的项目,目标是在你现有的游戏硬件上运行 1250 亿参数的大模型。它当然跑不动老式奔腾笔记本,但也不需要像超算一样的显卡阵列。
把显存当作模型缓存
Strata 支持多种 Qwen3.8 模型变体,包括原模型的不同量化版本,以及代码等专用版本。以 Qwen3.8-Flash-Next 为例,它是一个混合专家模型,包含 24576 个小专家,而每个 token 只需要其中 10 个。
巧妙之处在于,Strata 把显存当成更大模型的缓存:常用专家留在 GPU 上,完整的专家集合通常放在系统内存里。模型还带有一个约 29GB 的查找表,放在 SSD 上按需读取。
软件还利用模型的多 token 预测机制进行推测解码,一次检查多个候选 token。按照项目说法,一块 12GB 显存的 RTX 5070 根据量化不同,每秒大约能生成 50 到 90 个 token。token 通常不等于完整单词,但这个速度仍然相当可观。
安装与使用
安装过程未必顺利。测试时遇到了 NVIDIA C 编译器、gcc 版本和头文件不兼容的问题,不过不同环境下的麻烦可能各不相同。首次运行 setup.sh 会询问几个选项,之后便按选定的启动参数加载,加载过程可能持续几分钟。
运行起来后,可以通过浏览器与模型交互。它还会在本机 localhost 上暴露兼容 OpenAI 与 Anthropic 的 API,因此现有的聊天前端、编程助手等工具无需太多特殊处理,就能调用这个本地模型。
能力与门槛
别指望它在所有任务上都追平大模型。测试中问及 Hackaday 时,它答对了不少内容,却搞错了网站创始人和作者;调高“思考等级”、降低温度也没有太大帮助,只是把混淆转移到了其他事实上。让它找出问题代码,或者概述如何把某个 C 编译器移植到新目标时,表现会更好。
硬件门槛仍然不低:至少需要 32GB 系统内存、12GB 显存和约 80GB 存储空间。这里的“入门”只是相对而言。但它确实展示了混合专家模型和一些巧妙的内存管理,能把普通 PC 硬件推到什么程度。这类经济型大模型甚至能在更老的硬件上运行,只是速度更慢。


讨论
0 条评论